企业 AI 批量处理资料或业务任务时,并发越高不一定越快。本文说明如何设置队列、限流、隔离与结果对账,避免重复执行和资源拥塞。
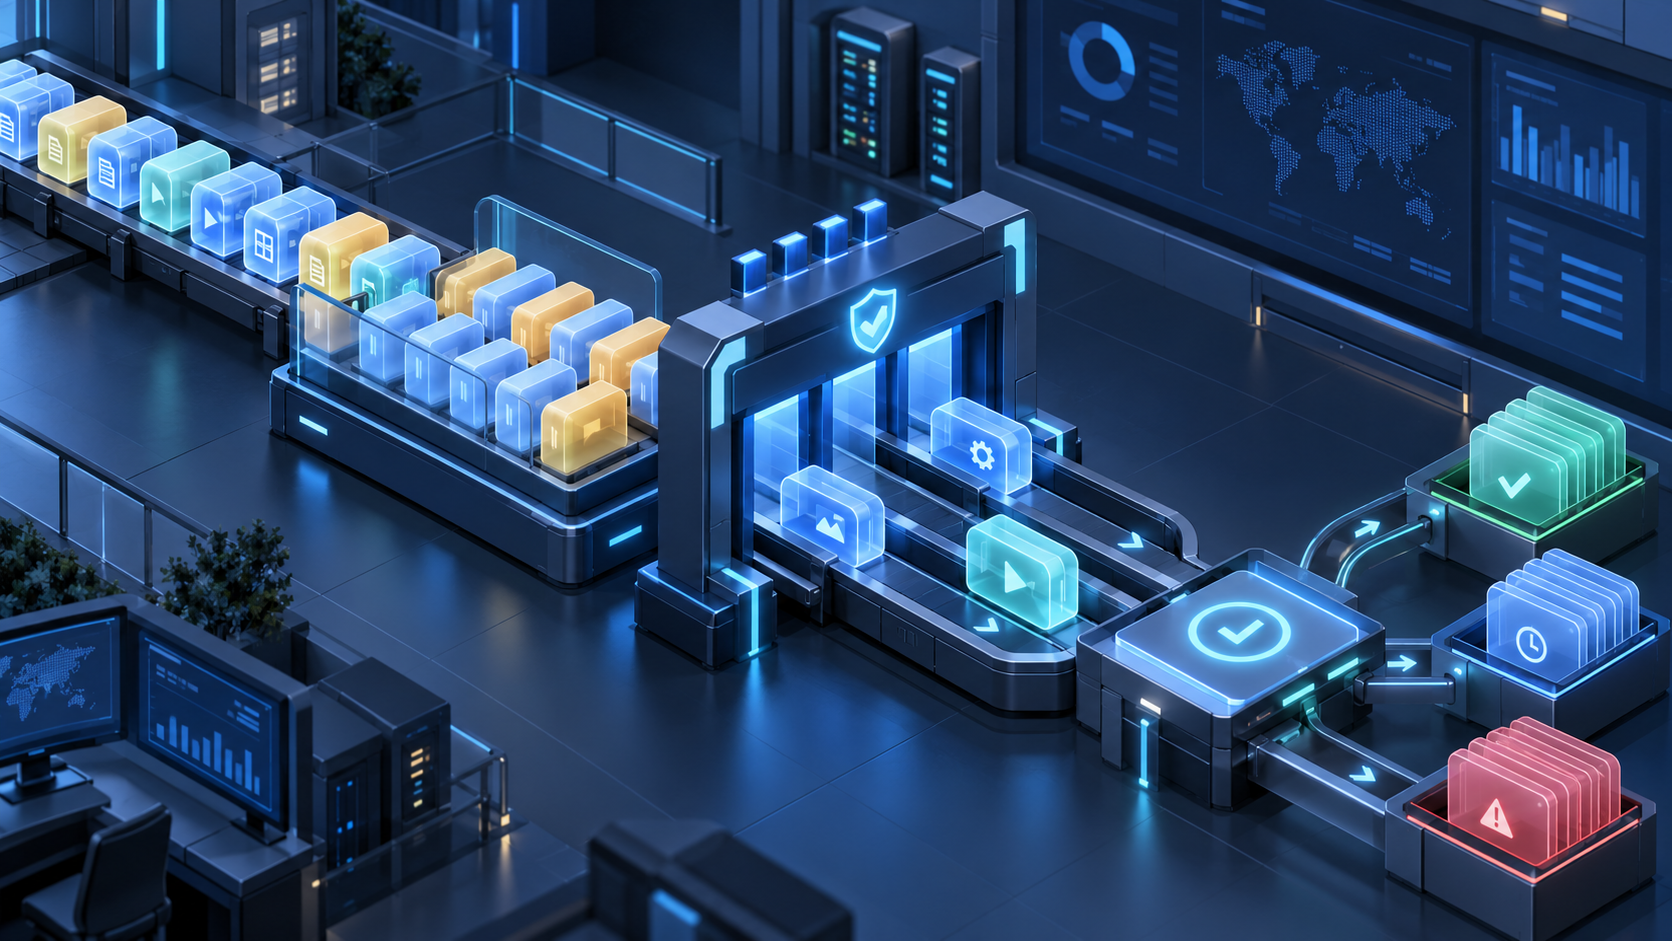
企业 AI 用于批量分类、资料摘要、字段提取或辅助回写时,团队容易把提高并发数理解为提升效率。实际上,模型服务、知识检索、业务接口和人工复核都有各自容量。若大量任务同时启动,可能造成排队失控、重复调用、结果错配和下游系统拥塞。并发控制的目标,是让任务在可观察、可恢复的节奏中完成。
先拆清一次批量任务的边界
每个批次需要明确输入集合、任务类型、发起人、使用版本和完成条件。单条任务应有稳定标识,并与原始业务对象关联。这样即使批次中断或被拆分执行,也能确认哪些记录已经处理、哪些仍在等待,避免只依赖一个总进度判断状态。
按最窄的下游容量设置并发
并发上限不能只看模型接口,还要考虑检索库、文件解析、业务写入和人工复核队列。可以分别设置全局上限、任务类型上限和单用户上限,并为高风险写入保留更低容量。当下游延迟上升或错误增多时,应主动降速,而不是继续堆积请求。
让队列体现优先级与公平性
紧急任务可以获得更高优先级,但不应长期挤占普通任务。队列规则应说明优先级来源、等待时限和暂停条件。对于同一业务对象的多个任务,可按顺序串行处理,防止并发写入互相覆盖;大批量任务则可分片,减少单次失败影响范围。
把异常重试与重复执行分开
网络失败、限流和业务校验失败需要不同处理方式。只有能确认动作未发生时才可自动重试;响应不确定或可能已经写入时,应先查询业务结果。重试需要沿用稳定任务标识,并限制次数与间隔,不能通过不断并发重发掩盖真正的容量或数据问题。
批次结束后进行结果对账
对账应比较输入数量、成功结果、待核对、明确失败和被取消任务,并关联实际业务记录。总数相等仍不足以证明正确,还要抽查对象对应关系和写入状态。未完成任务应保留原因、责任人和下一步,批次只有在差异被解释后才适合关闭。
常见问题
并发数越高,批量任务一定越快吗?
不一定。超过下游容量后,排队、限流和重试反而会拉长完成时间并增加风险。
失败任务可以全部自动重试吗?
不可以。可能已经产生业务变化或参数不合法的任务,应先核对状态或转人工处理。
结果对账只核对成功数量够吗?
不够。还需确认每个输入与输出、业务对象和最终状态准确对应。