企业 AI 接入业务资料前,应先识别敏感字段并按任务需要脱敏。本文说明如何划定范围、选择替换方式、控制还原权限并验证业务可用性。
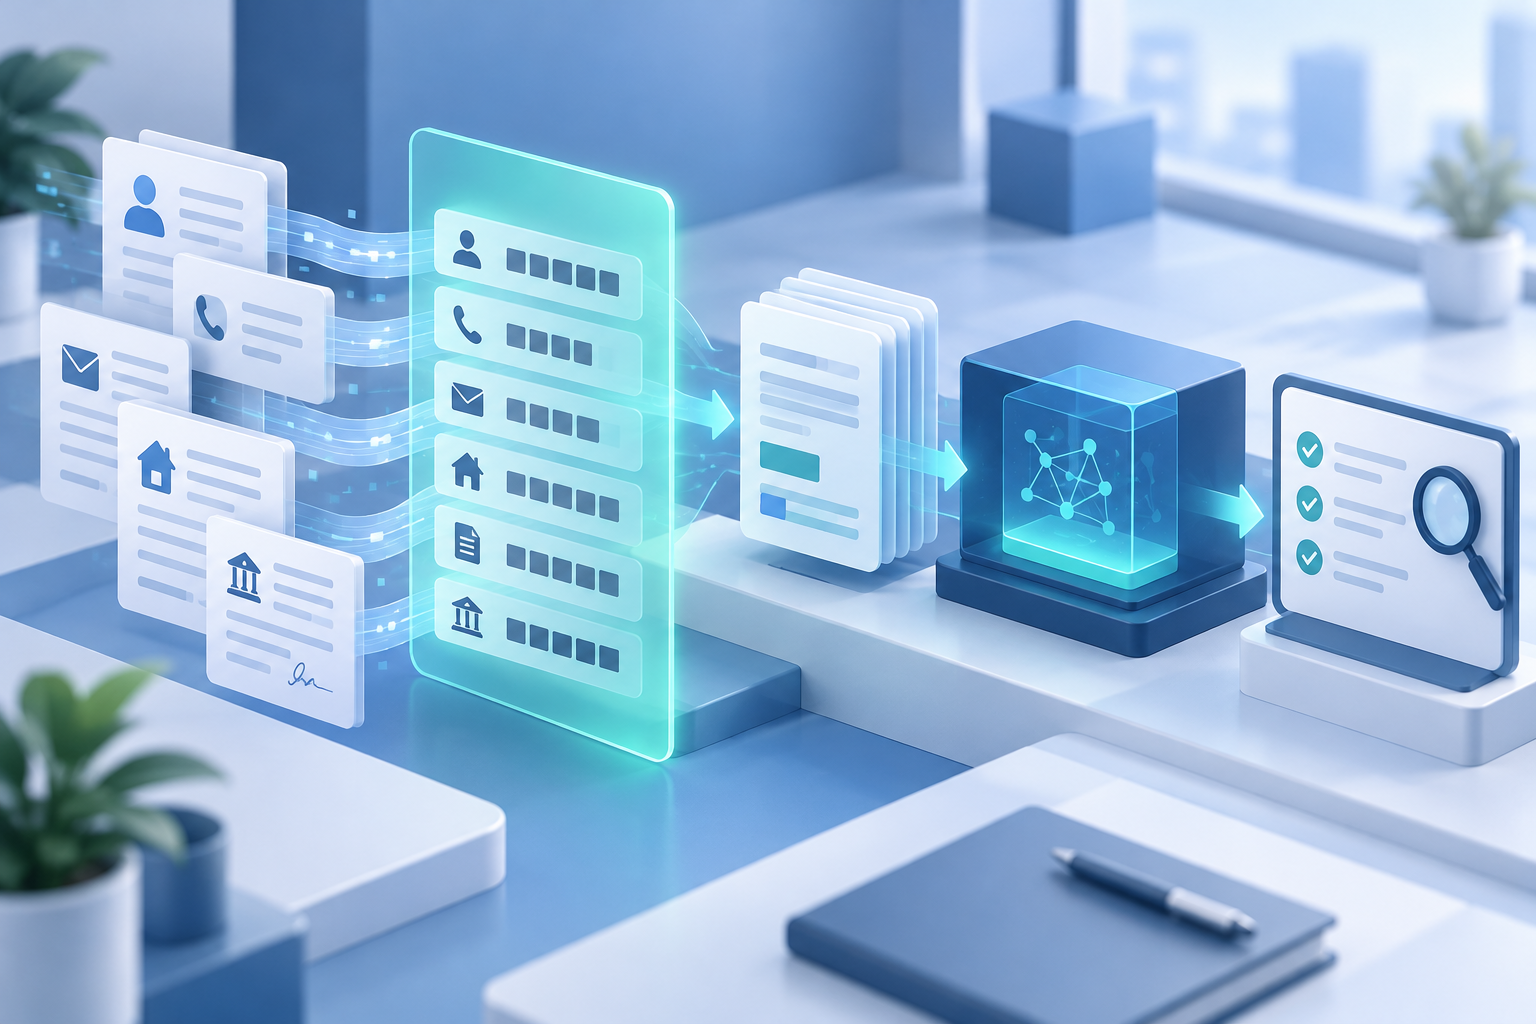
企业 AI 处理合同、工单、客户沟通或员工资料时,输入中可能同时包含姓名、联系方式、账号、金额和内部标识。若把完整原文直接交给模型,容易扩大敏感信息的暴露范围;若一律删除,又可能让任务失去判断依据。更稳妥的做法,是围绕具体任务建立可验证的脱敏流程,让模型只看到完成任务所必需的信息。
先从任务目的确定必要字段
同一份资料用于摘要、分类、风险提示或生成回复时,需要的信息并不相同。团队应先列出任务目标、允许使用的数据范围和必须保留的上下文,再决定哪些字段可以删除、替换或模糊化。没有明确用途的敏感字段不应因为“可能有用”而默认保留。
建立可维护的敏感信息分类
字段识别不能只依赖固定关键词。除了姓名、电话、证件和银行账号等明显信息,还要考虑业务编号、地址、合同价格、内部角色和组合后可识别个人的信息。分类规则需要说明来源、风险等级和适用场景,并在业务字段变化后及时更新。
按任务选择合适的脱敏方式
删除适合完全无关的字段;局部遮蔽适合保留格式特征;稳定替换可以让同一对象在一批材料中保持一致代号;区间化则可保留金额或时间的分析意义。所选方式要兼顾隐私与任务可用性,避免脱敏后仍能通过其他字段轻易反推出原值。
把还原权限与模型处理分开
需要把生成结果回填给具体对象时,可在受控系统中保存原值与代号的映射,但映射不应随内容一起发送给模型。还原动作应由明确身份、数据权限和业务流程控制,并记录操作者、时间、用途和影响对象。无需还原的任务应使用不可逆方式。
用样本验证遗漏和误伤
上线前应准备覆盖不同文件格式、字段写法和组合关系的测试样本,既检查敏感信息是否遗漏,也检查关键业务含义是否被过度遮蔽。运行后可对新出现的写法建立问题样本,经过人工确认再更新规则,并对历史任务进行必要的回归验证。
常见问题
使用企业版模型就可以不脱敏吗?
不能仅凭产品类型下结论。仍需依据任务必要性、合同约定、数据分类和实际处理边界决定输入范围。
把姓名替换成星号就足够了吗?
不一定。联系方式、地址、订单关系等信息组合后仍可能识别对象,需要按整体上下文检查。
脱敏后如何把结果对应回业务记录?
可由业务系统保留受控映射,在模型处理完成后按权限还原,映射本身不进入模型上下文。