企业 AI 运行中出现的错误、拒答和不确定结果,需要经过收集、归因、修正与回归验证。本文梳理失败样本治理的落地方法。
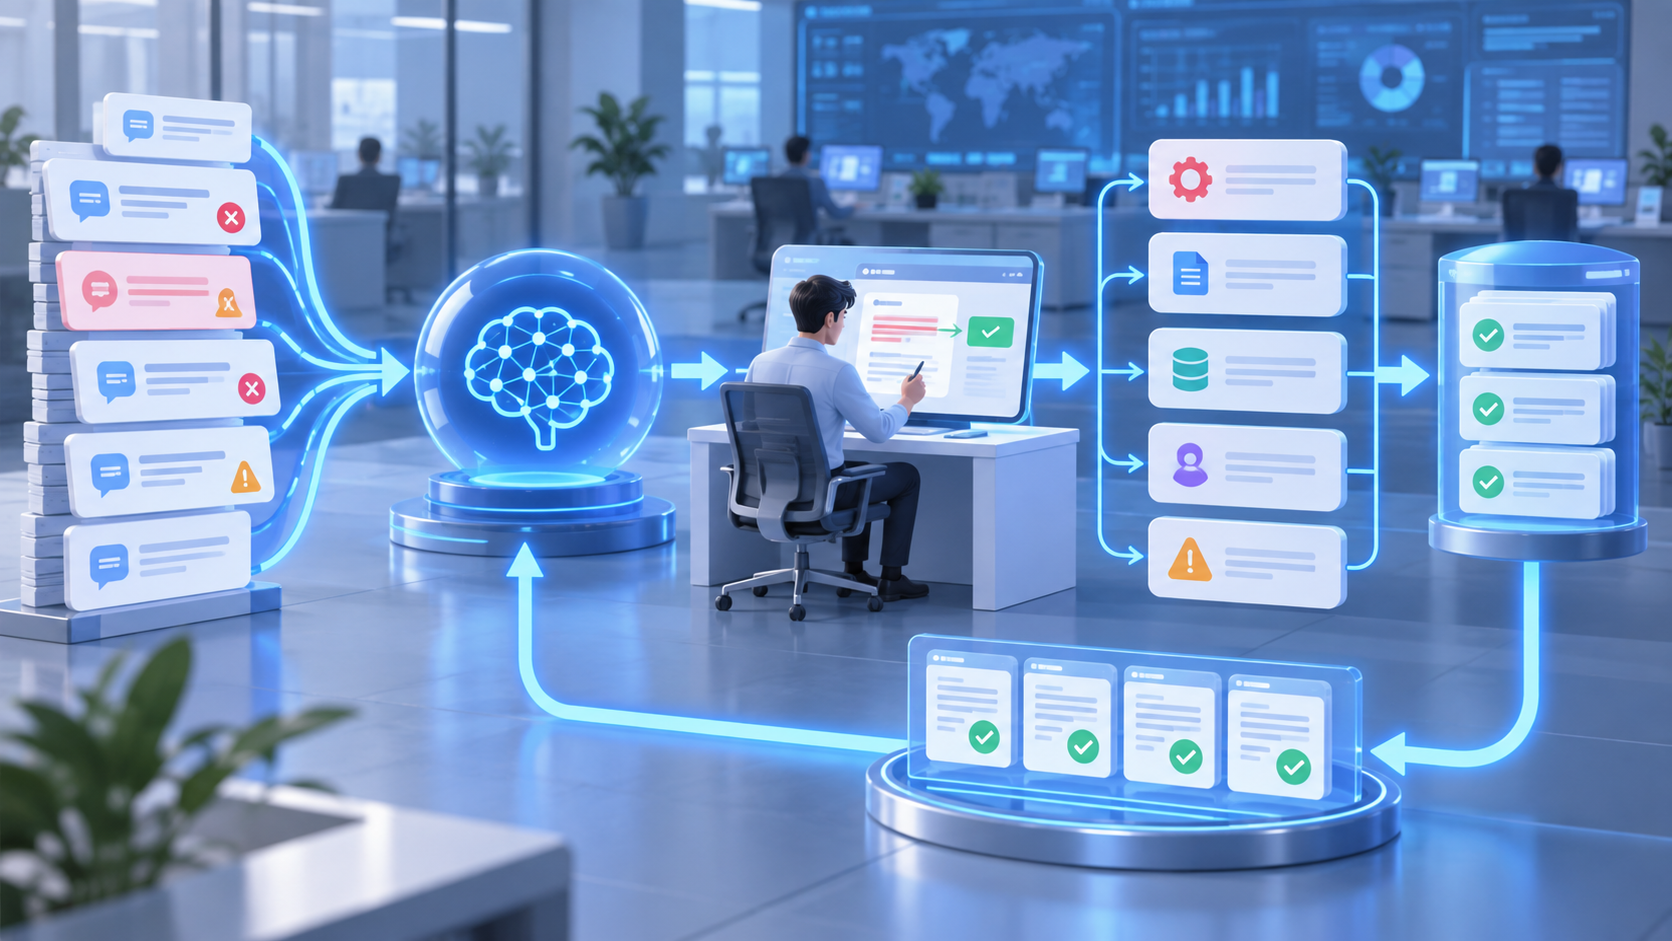
企业 AI 投入实际业务后,错误答案、依据不足、工具调用失败和人工驳回都会持续出现。若只修正当次结果,同类问题往往还会重复。失败样本治理的目标,是把真实运行中的问题转化为可分析、可修正、可验证的改进输入,同时避免把含有敏感信息的原始记录无边界留存。
先统一什么算失败样本
失败不只包括明显答错,还可包含拒答不当、信息遗漏、引用失配、格式不合规、工具执行中断和需要人工改写等情况。应按业务任务定义判定标准,记录期望结果与实际差异,避免仅凭“感觉不好”进入样本库。
收集时保留必要上下文
一个样本至少应关联任务类型、输入摘要、模型或流程版本、使用的知识来源、工具返回和人工处理结论。对个人信息、商业秘密和访问凭据,应在进入分析环境前做删除或脱敏,并限制样本的可见范围和保留期限。
按根因而不是表象分类
同样表现为答案不准确,原因可能是源资料过期、检索未命中、指令冲突、字段映射错误或模型能力边界。先区分数据、知识、流程、权限和生成环节,再决定修正文档、规则、工具还是人工协作方式,避免只修改提示词。
修正后形成可执行措施
每类问题应指定负责人、处理方式和适用范围。修正内容要记录版本,并说明可能影响的其他任务。对于高风险场景,可先在影子流程或有限范围验证,确认不会引入新的权限或业务风险后再放行。
用固定样本做回归验证
将具有代表性的失败样本与正常样本组成测试集,变更后同时检查问题是否消失、原有能力是否退化。测试结果应与版本绑定。若样本来自持续变化的业务,还要定期淘汰失效样本并补充新的边界情况。
常见问题
所有失败记录都要长期保存吗?
不需要。应按风险和复用价值筛选,设置脱敏、访问权限和保留期限。
人工改写过的答案能直接作为标准答案吗?
不宜直接采用。应确认改写依据、适用条件和审核责任,再决定是否进入测试集。
失败样本数量越多越好吗?
不一定。覆盖关键任务和典型边界比简单累积数量更重要,还要避免大量重复样本影响分析效率。