企业 AI 面对长文档和多轮材料时,需要按任务保留关键事实、来源与约束。本文梳理上下文压缩和预算管理的落地方法。
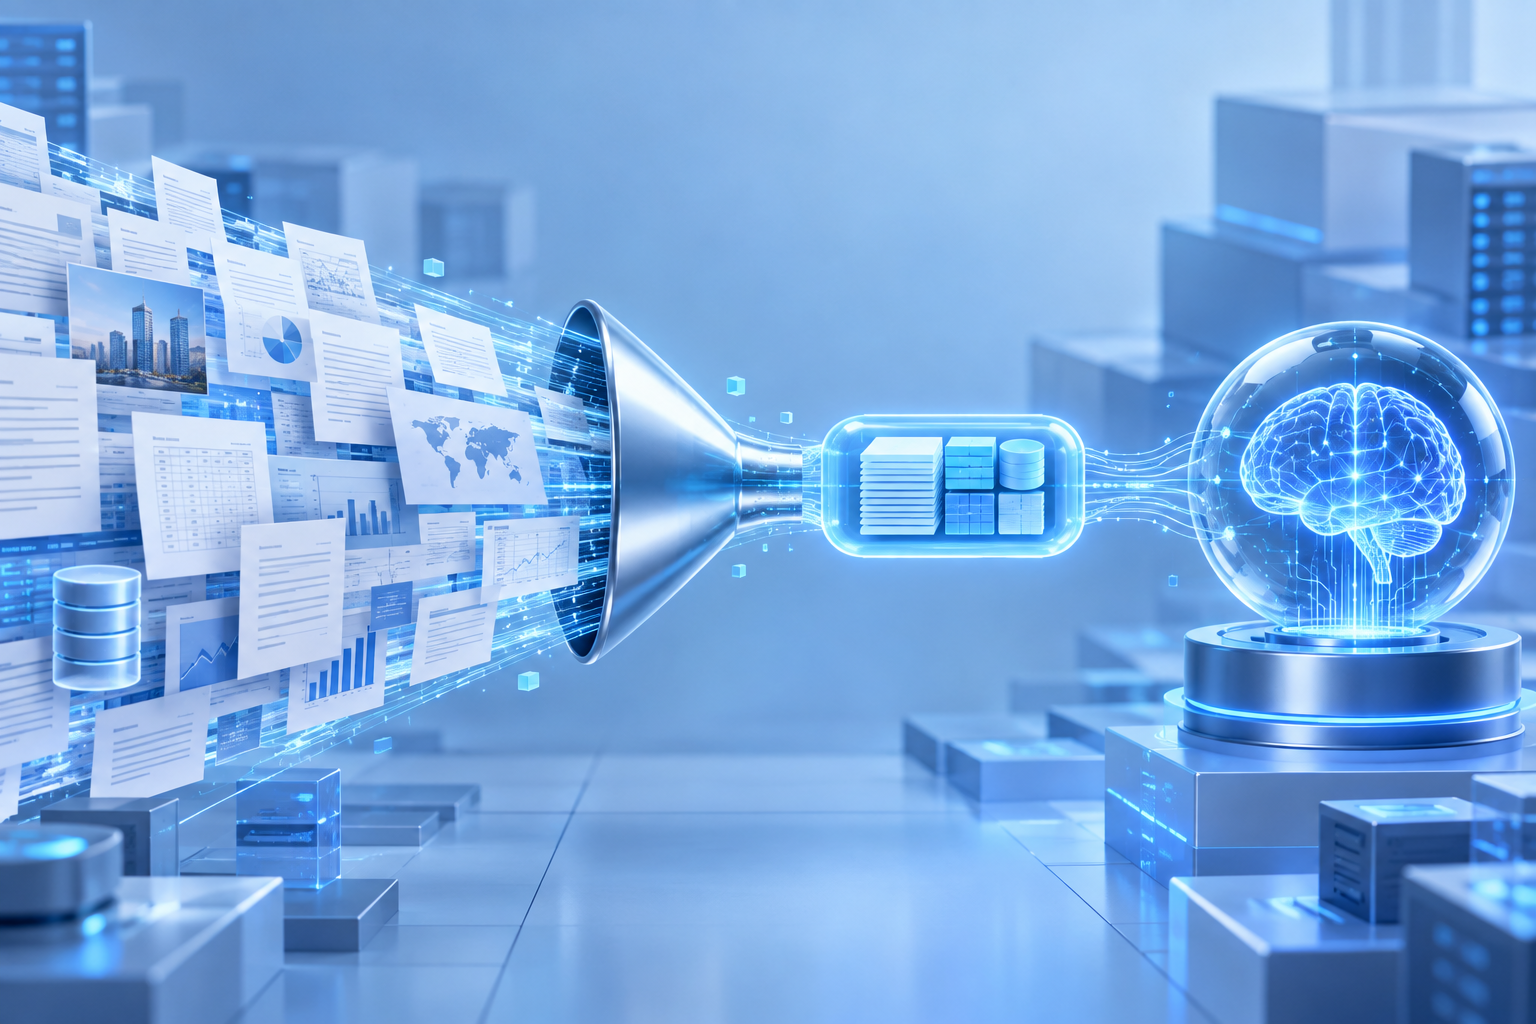
企业 AI 在处理长合同、多轮服务记录或成组制度文件时,并不是输入越多越好。材料过长会抬高处理成本,也可能让真正影响任务的事实被重复描述淹没。上下文压缩的目的不是简单删短,而是在可追溯的前提下,为每个任务保留足够且相关的信息。
先明确任务需要回答什么
同一份材料用于风险审查、要点提取或回复草拟时,需要的信息范围不同。压缩前应写清任务目标、输出格式和不可遗漏的约束,并将身份、时间、金额、责任等关键字段列为保留项,避免使用一套摘要服务所有场景。
给上下文分配信息预算
可将信息分为当前指令、关键事实、引用依据、历史过程和辅助背景。优先保留会改变业务判断的内容,对重复叙述和低相关背景做合并。预算还应为模型输出和工具返回预留空间,避免输入占满后截断结果。
压缩时保留来源指针
摘要中的关键事实应关联原文位置、文档版本和提取时间。这样使用者发现疑点时可以回看依据,也便于在源文件更新后判断哪些压缩内容需要重建。无法定位来源的结论,不宜直接驱动关键动作。
区分事实、规则与临时推断
压缩结果应标识哪些是原始事实、哪些是业务规则、哪些只是为完成任务生成的临时判断。三者混在一起时,后续轮次容易把推断误当成已经确认的事实。对不确定或冲突内容,应保留原始差异并转入复核。
用任务结果反向检查压缩质量
验证不应只比较字数,还要用代表性任务检查遗漏、误合并和来源错配。若某类异常总在压缩后消失,应调整保留规则或直接引用原文。规则变更后,用固定样本回归,确认成本下降没有换来不可接受的信息损失。
常见问题
上下文压缩是否等于生成摘要?
不完全相同。摘要强调简洁,任务上下文还要保留约束、来源、权限和后续动作所需结构。
所有历史对话都应该放入上下文吗?
不应默认全部放入。应按当前任务选择相关事实,并防止过期结论继续影响新任务。
怎样判断压缩过度?
若关键问题无法回到原始依据、任务结果频繁遗漏例外,或复核者需要反复补充材料,通常说明压缩规则过强。