从置信度的业务含义、分流阈值、复核队列与闭环记录出发,说明企业AI如何把不确定结果安全地交给人工处理。
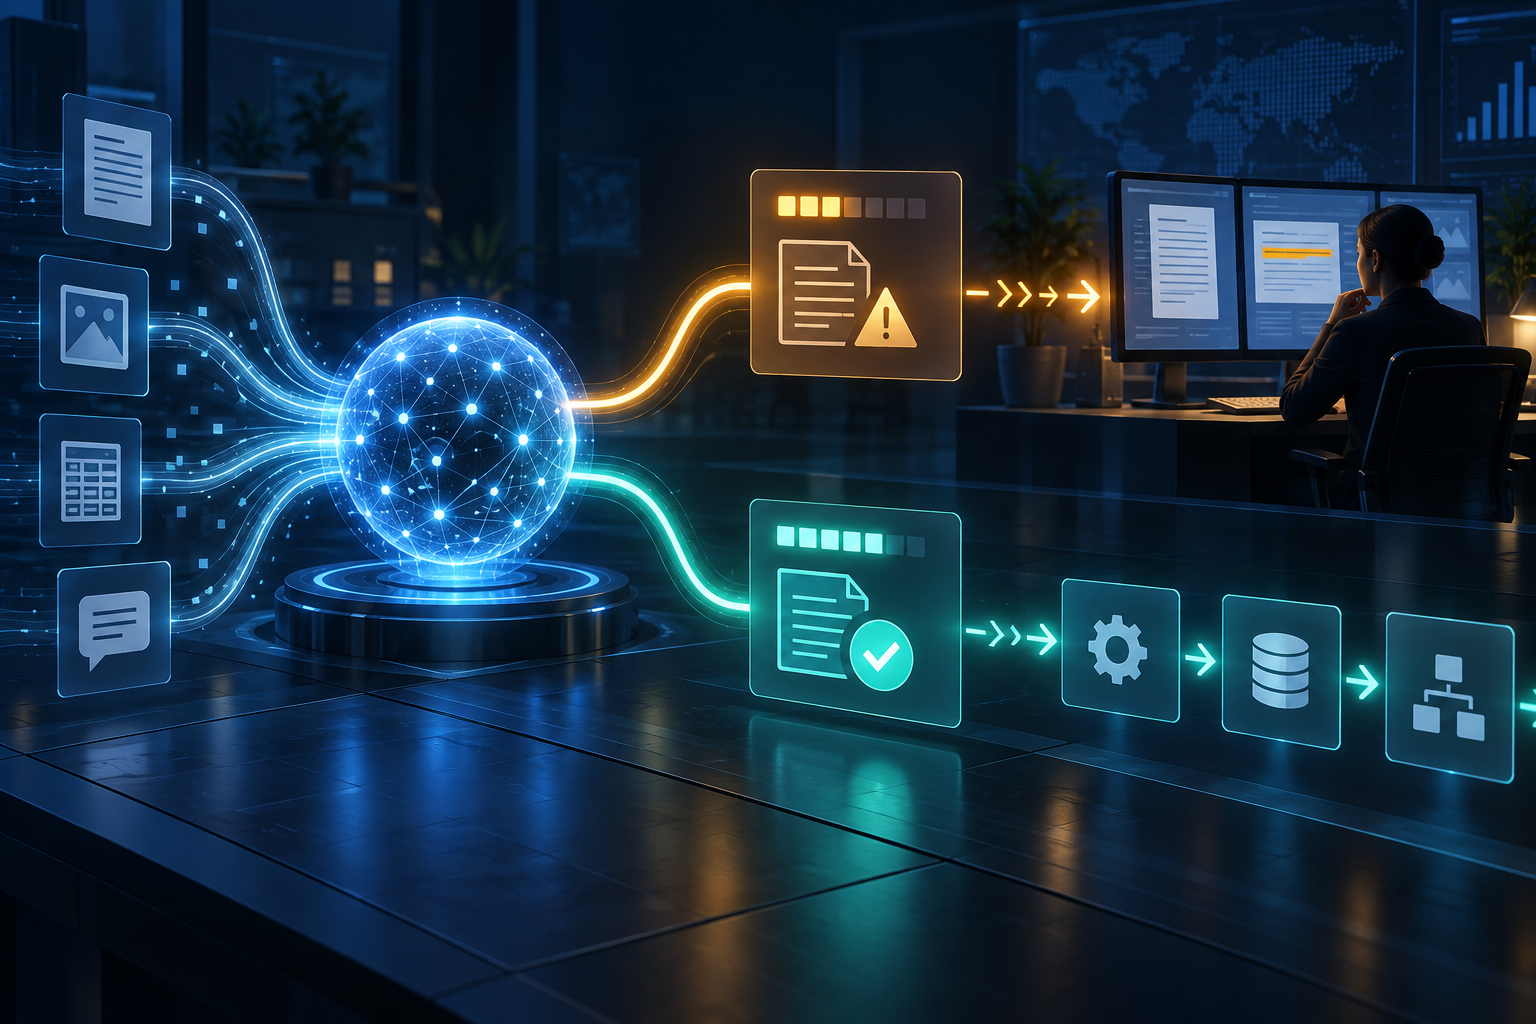
企业AI进入真实业务后,系统很少只面对“正确”或“错误”两种状态。更多时候,模型能够给出一个看似完整的结果,但证据并不充分、输入存在缺口,或者当前任务本身风险较高。此时,置信度不应只是技术界面上的一个分数,而应成为任务分流的信号:哪些结果可以继续流转,哪些需要补充资料,哪些必须由人复核。
先定义置信度在业务中的含义
不同模型给出的分数未必可以直接比较,同一个分数在不同场景中的含义也可能不同。企业首先要明确:分流依据究竟来自模型自身评分、规则校验结果、知识来源完整度,还是多个信号的组合。对于合同要点提取、服务工单分类和内部知识问答等任务,输入质量、来源时效和关键字段完整性都可能影响最终判断。
因此,业务侧需要用一批经过人工确认的样本观察各类信号与实际结果之间的关系,再为具体场景设定解释口径。不要把一个统一阈值复制到所有任务,更不要把高分等同于绝对正确。
按风险而不是按方便设置分流路径
合理的分流通常至少包含三条路径。低风险且校验通过的结果可以进入下一步,但仍保留抽样复核;信息不完整或信号相互冲突的结果进入待补充队列;涉及关键金额、对外承诺、权限变更或重要业务判断的结果,即使评分较高,也应进入人工确认。
阈值设置应围绕错误后果展开。可撤回、可追踪的内部建议,可以采用相对宽松的自动流转条件;难以逆转或影响范围较大的动作,则应采用更严格的复核要求。这样的设计能避免团队为了追求自动化比例而忽视业务责任。
让人工复核成为可管理的工作队列
如果所有不确定任务只是被简单地“退给人工”,复核人员很快会面对大量缺少上下文的记录。复核队列应同时展示原始输入、AI结果、引用依据、触发分流的原因和建议动作,并按照业务风险、等待时间和责任范围排序。
复核结果也应结构化记录,例如确认采用、修改后采用、要求补充信息或拒绝执行。这样既方便追踪单个任务,也能为后续调整阈值和优化知识来源提供依据。
持续校准而不是一次设定
业务内容、模型版本和知识库都会变化,原先有效的阈值可能逐渐失去代表性。企业可以按周期复盘自动通过率、人工修改率、异常类型和等待时长,并关注某些部门、任务类型或数据来源是否集中出现偏差。出现明显变化时,应先查明输入和流程原因,再决定是否调整分流规则。
置信度分流的目标并不是让更多任务自动完成,而是让不同风险的任务走向合适的处理路径。把信号解释、业务规则、人工复核和结果回写连成闭环,企业AI才能在效率与可控之间保持稳定平衡。
常见问题
置信度高的结果可以直接执行吗?
不一定。是否直接执行还要结合任务风险、规则校验和操作是否可逆。高风险动作通常仍需人工确认。
人工复核量太大时应该先调低阈值吗?
应先分析分流原因。如果主要问题来自输入缺失、知识过期或规则冲突,直接调整阈值可能掩盖真正的问题。