企业 AI 接入业务场景时,不应默认把完整记录交给模型。本文从任务目标、字段筛选、脱敏、权限、临时数据和调用留痕说明输入数据最小化方法。
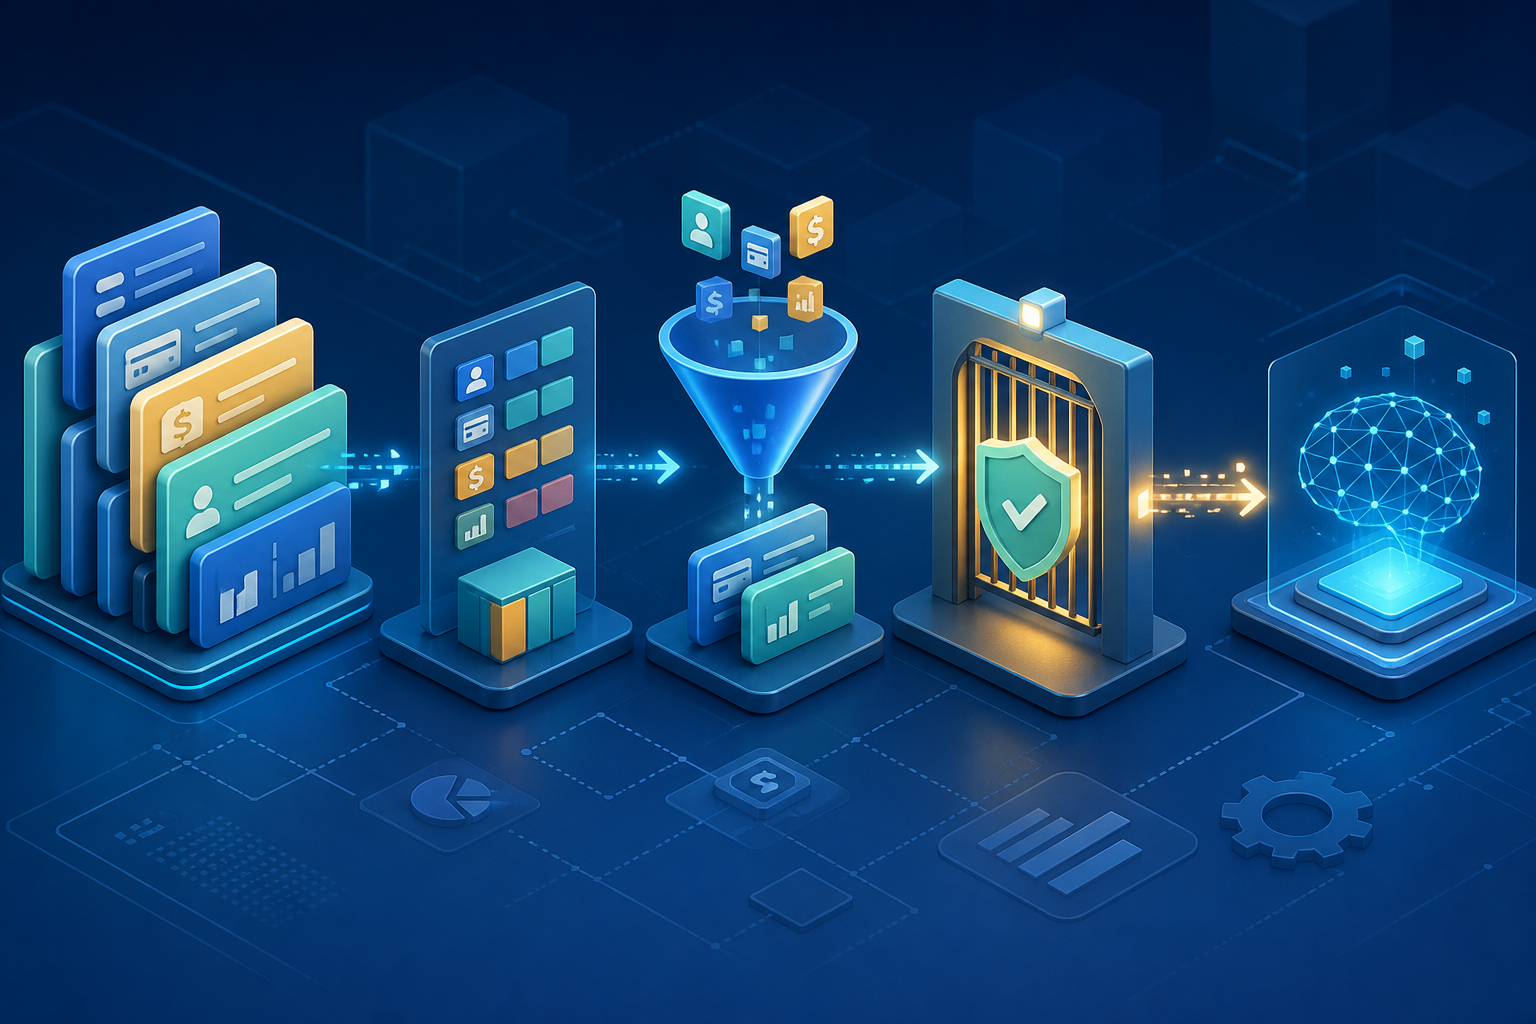
企业把 AI 接入知识查询、信息归纳或业务辅助时,常见风险并不只来自模型输出,也来自输入范围过大。如果为了方便把整张业务表、完整附件或历史对话直接交给模型,系统可能处理与任务无关的个人信息、商业资料和权限外内容。更稳妥的方法是先明确任务,再决定本次调用真正需要哪些字段、多久有效以及谁可以使用结果。
从任务目标反推必要数据
同一条记录在不同任务中需要的信息并不相同。生成工单摘要可能只需要问题描述、处理节点和当前状态;判断下一步责任角色可能需要事项类型与组织规则,但未必需要联系人电话。设计时可为每类 AI 任务建立输入清单,并说明每个字段为何必要,避免沿用“整条记录全部传入”的默认做法。
区分业务字段与上下文噪声
备注、附件、历史消息和复制粘贴内容常包含大量无关信息。系统可先按数据类型和来源整理上下文,去除重复段落、过期版本与无关引用。无法确认是否必要的内容,不应自动扩大范围;可以由有职责的使用者选择补充,或进入待确认状态。
在调用前完成脱敏与替换
必须保留业务关系但无需暴露真实值时,可使用内部编号、角色标签或区间信息替代姓名、证件号码、联系方式和精确金额。脱敏规则应与任务目的相匹配,不能只遮住页面显示而仍把原始值发送出去。涉及法定保存、行业规则或特殊类别数据时,应由相应职责人员确认处理方式。
权限校验跟随原始数据
AI 入口不能成为绕过原系统权限的新通道。检索、汇总和工具调用都应继承当前用户对原始记录、字段和附件的可见范围。用户无权查看的数据,不应因为被写入提示或知识索引而出现在结果中;跨部门汇总还应确认是否允许展示明细。
限制临时数据与会话延续
一次任务需要的输入,不代表可以在后续会话持续复用。系统应明确会话边界、缓存时长和清理条件,避免新任务无意带入旧客户、旧项目或旧权限状态。需要连续处理时,也应重新检查关键数据是否更新、授权是否仍然有效。
外部调用先说明数据去向
使用外部模型或工具前,应了解数据经过哪些服务、是否被保存、能够配置哪些保留策略以及异常时怎样处置。不能确认边界时,可先采用经过处理的样例或内部受控能力验证流程,不把真实敏感数据作为试运行材料。
用可复核记录支持持续治理
调用记录可保留任务类型、输入字段类别、脱敏规则、权限结果、模型或工具版本和最终状态,但不应在日志中再次复制完整敏感正文或密钥。定期复核被拒绝的字段、人工补充内容和异常调用,有助于调整最小输入清单,而不是不断扩大默认权限。
常见问题
数据越少是否一定会降低 AI 效果?
不一定。去除无关和冲突信息往往有助于聚焦任务;若确有关键缺口,应通过明确的补充步骤提供,而不是一次性开放全部数据。
脱敏后就可以随意调用外部模型吗?
不能。仍需判断数据是否可还原、组合后是否敏感,并核对服务边界、合同约定和适用制度。
权限只在用户打开 AI 功能时检查一次可以吗?
通常不够。检索、生成、工具执行和结果查看可能处于不同时间点,关键环节应按当前身份与数据状态重新校验。